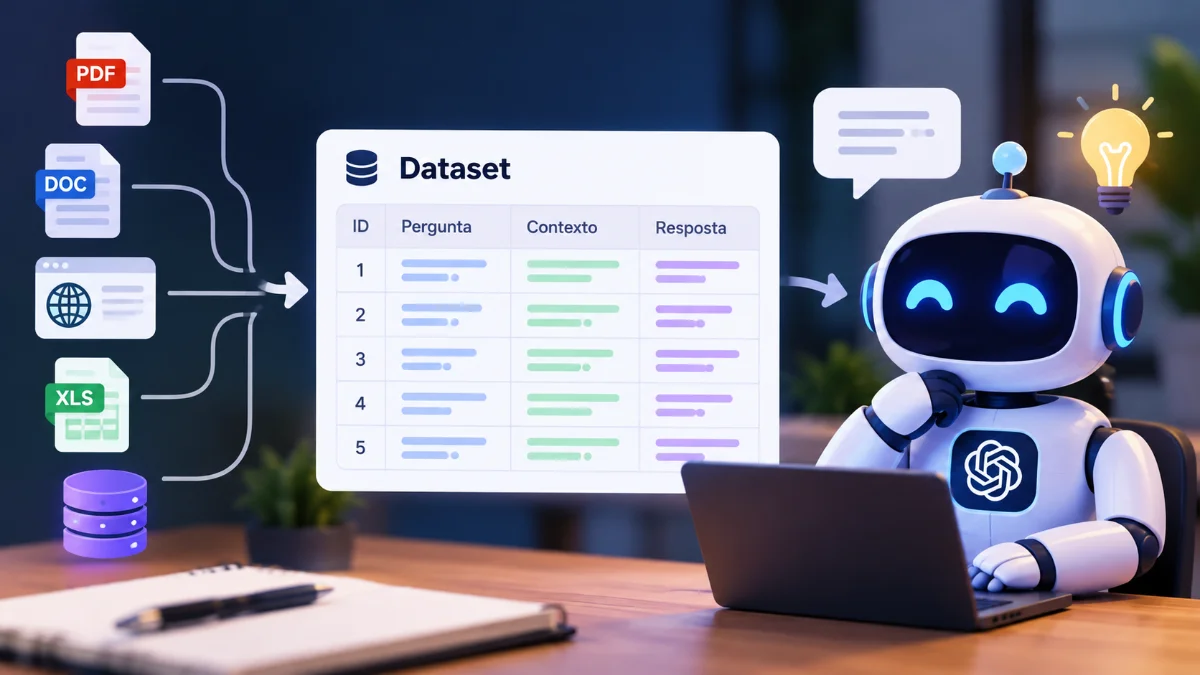
Só um dataset permite medir um agente de IA: um conjunto de casos com o comportamento esperado em cada um. Sem esse conjunto, o time ajusta prompts no olho e descobre os erros pela reclamação do cliente. Este artigo mostra como o product manager define, monta, rotula e mantém esse dataset.
O texto serve a PMs e heads de produto que lançam ou mantêm agentes em produção. Todos os exemplos usam o mesmo caso: o agente de suporte de uma empresa de software B2B. Esse agente responde dúvidas, consulta faturas, emite segunda via de boleto, abre chamados e transfere a conversa para um atendente.
O caminho tem oito etapas: contrato do agente, formato do registro, fontes de dados, cobertura, rotulagem, avaliação, tamanho e ciclo de vida. No fim, o artigo traz papéis, erros comuns e um plano de 30 dias.
O que é um dataset de agente
Um dataset de agente reúne situações reais ou realistas, cada uma com o comportamento que o agente deve ter. Ele mede ações, e não só o texto da resposta.
Três tipos de dataset
Tipo | Para que serve | Quem usa | Quando o PM precisa dele |
|---|---|---|---|
Avaliação (eval set) | Medir se o agente cumpre a tarefa | Produto e engenharia | Sempre, antes do primeiro lançamento |
Exemplos no prompt (few-shot) | Mostrar ao modelo o formato e o tom esperados | Engenharia de prompt | Quando o agente erra formato ou tom |
Treino (fine-tuning) | Ajustar os pesos do modelo | Time de ML | Raro: a maioria dos agentes usa modelo de terceiros sem ajuste de pesos |
Este artigo trata do dataset de avaliação. É o que o PM controla e o que decide se uma versão vai para produção.
O que muda quando o sistema é um agente
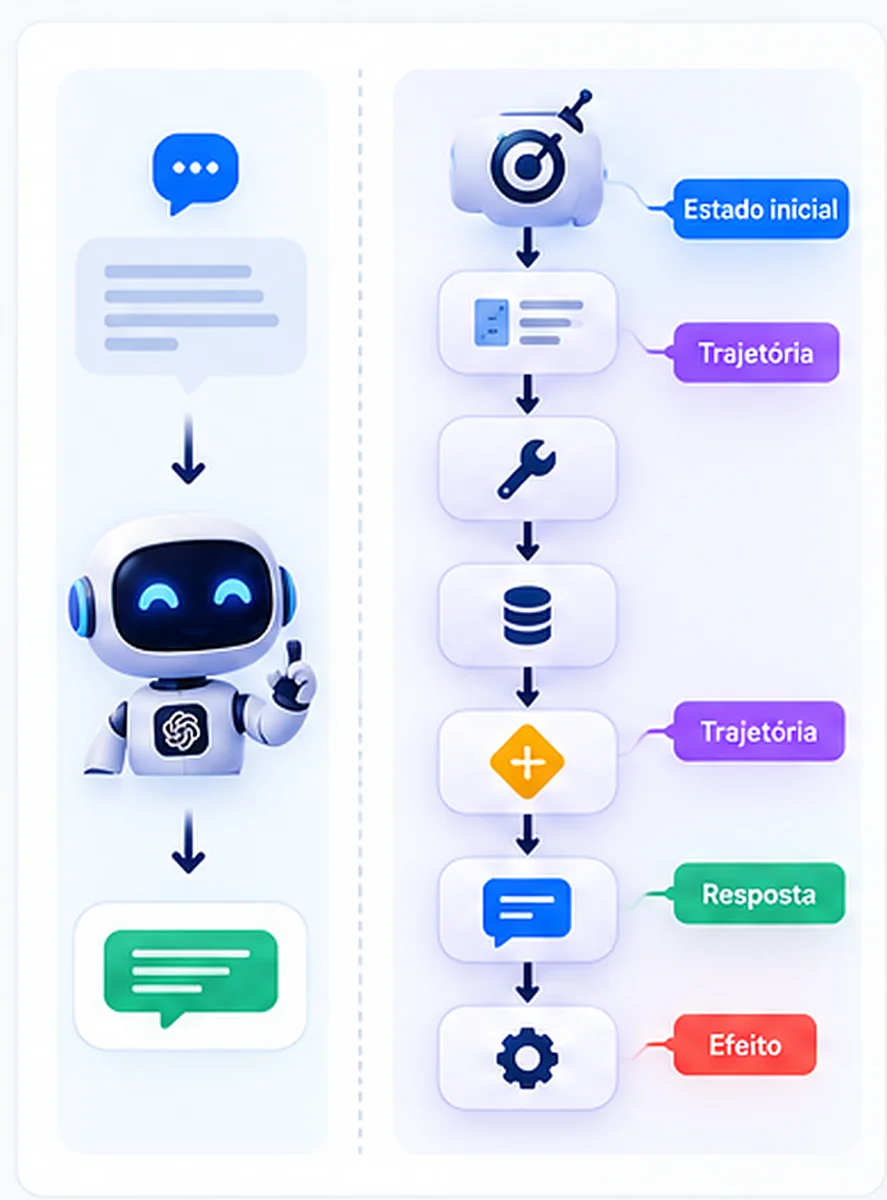
Um chatbot recebe uma pergunta e devolve um texto. Um agente recebe um objetivo, decide passos, chama ferramentas, lê os resultados e só então responde.
Por isso o dataset de agente registra quatro elementos que um dataset de chatbot ignora:
Estado inicial: dados do cliente, histórico da conversa e permissões.
Ferramentas disponíveis: o que o agente pode chamar e com quais parâmetros.
Trajetória: quais ferramentas o agente deve chamar, com quais dados, e quais ele não pode chamar.
Efeito no sistema: o chamado aberto, o boleto emitido, a conversa transferida.
O agente pode escrever uma resposta correta e errar a ação. Exemplo: ele diz "abri seu chamado", mas nunca chamou a ferramenta abrir_chamado. Um dataset que só compara textos não detecta esse erro.
Por que o dataset é uma decisão de produto
Quem escreve a resposta esperada define o que o produto faz. O dataset funciona como uma especificação executável: cada caso é um requisito que o sistema testa a cada versão.
Três decisões ficam com o PM:
O que conta como sucesso. Em uma cobrança contestada, o agente resolve sozinho ou transfere para um atendente? A resposta vira regra no dataset.
Quais erros são inaceitáveis. Emitir boleto para o CNPJ errado pesa mais do que responder com tom formal. O dataset separa esses casos e dá peso diferente a cada um.
Qual nota libera uma versão. Sem um número de corte, cada release vira um debate de opinião.
Sem dataset, o time compara versões lendo meia dúzia de conversas. Esse método não detecta regressão: uma mudança de prompt que melhora as respostas sobre faturas pode piorar as de cancelamento sem ninguém notar.
Antes de coletar: defina o contrato do agente
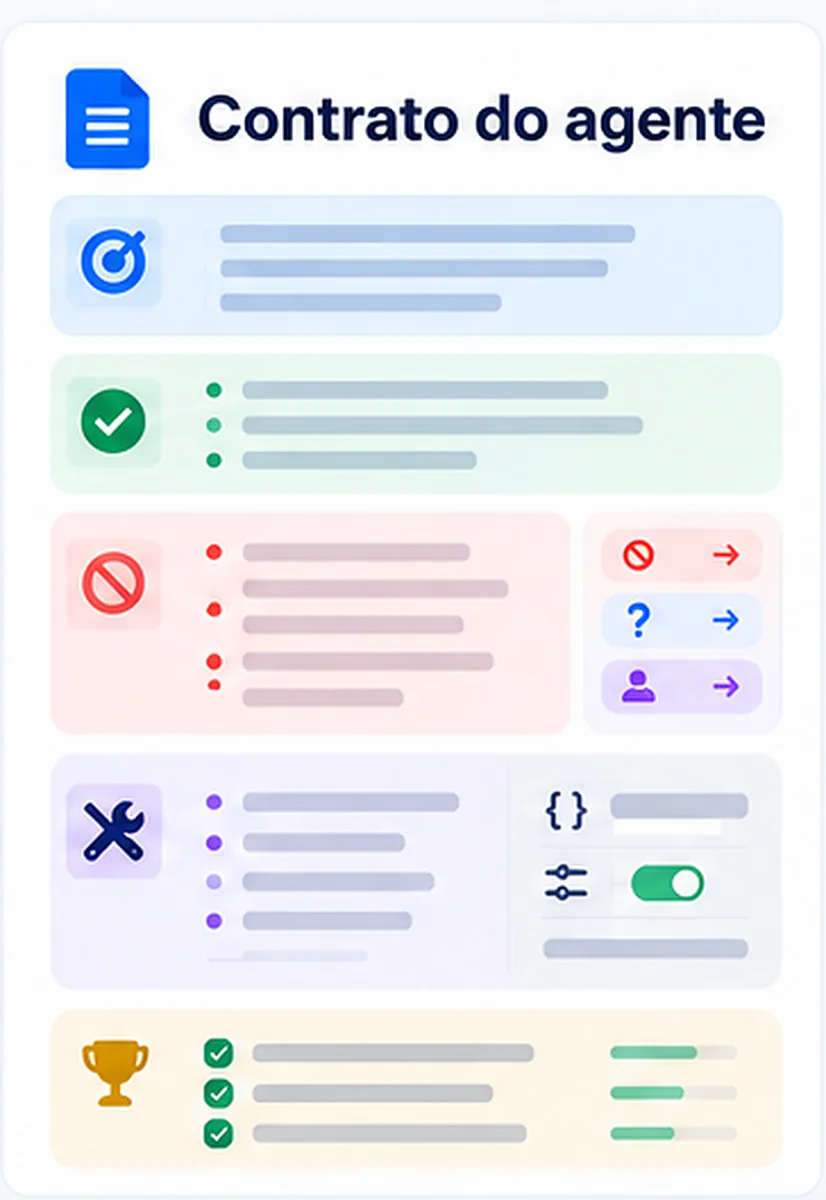
O primeiro entregável é um contrato de uma página, e não o dataset. O contrato diz o que o agente faz, com quais ferramentas e como o time mede cada tarefa. Sem ele, cada rotulador decide a resposta certa do próprio jeito.
Escopo
Liste as tarefas que o agente executa e as que ele não executa. Para cada tarefa fora do escopo, defina o comportamento: recusar, pedir informação ou transferir.
No agente de suporte, renegociar dívida fica fora do escopo. O comportamento esperado é transferir para o time financeiro com um resumo da conversa.
Ferramentas e permissões
Liste cada ferramenta, os parâmetros obrigatórios e as condições de uso. Exemplo: emitir_segunda_via exige CNPJ validado e fatura em aberto. O agente não pode chamar essa ferramenta para uma fatura já paga.
Critérios de sucesso por tarefa
Tarefa | Ação esperada | Resultado aceitável | Resultado inaceitável |
|---|---|---|---|
Segunda via de boleto | consultar_fatura e emitir_segunda_via | Link do boleto da fatura pedida | Boleto de outra fatura ou de outro CNPJ |
Dúvida sobre cobrança | consultar_fatura e explicar os itens | Explicação que bate com os itens da fatura | Valor que não existe na fatura |
Pedido de cancelamento | transferir_para_humano com o motivo | Transferência com resumo | Promessa de cancelar sem transferir |
Falha técnica | abrir_chamado com categoria e descrição | Chamado na categoria certa | Resposta genérica sem chamado aberto |
Essa tabela vira a base do guia de rotulagem. Cada linha gera pelo menos uma categoria no dataset.
Anatomia de um caso
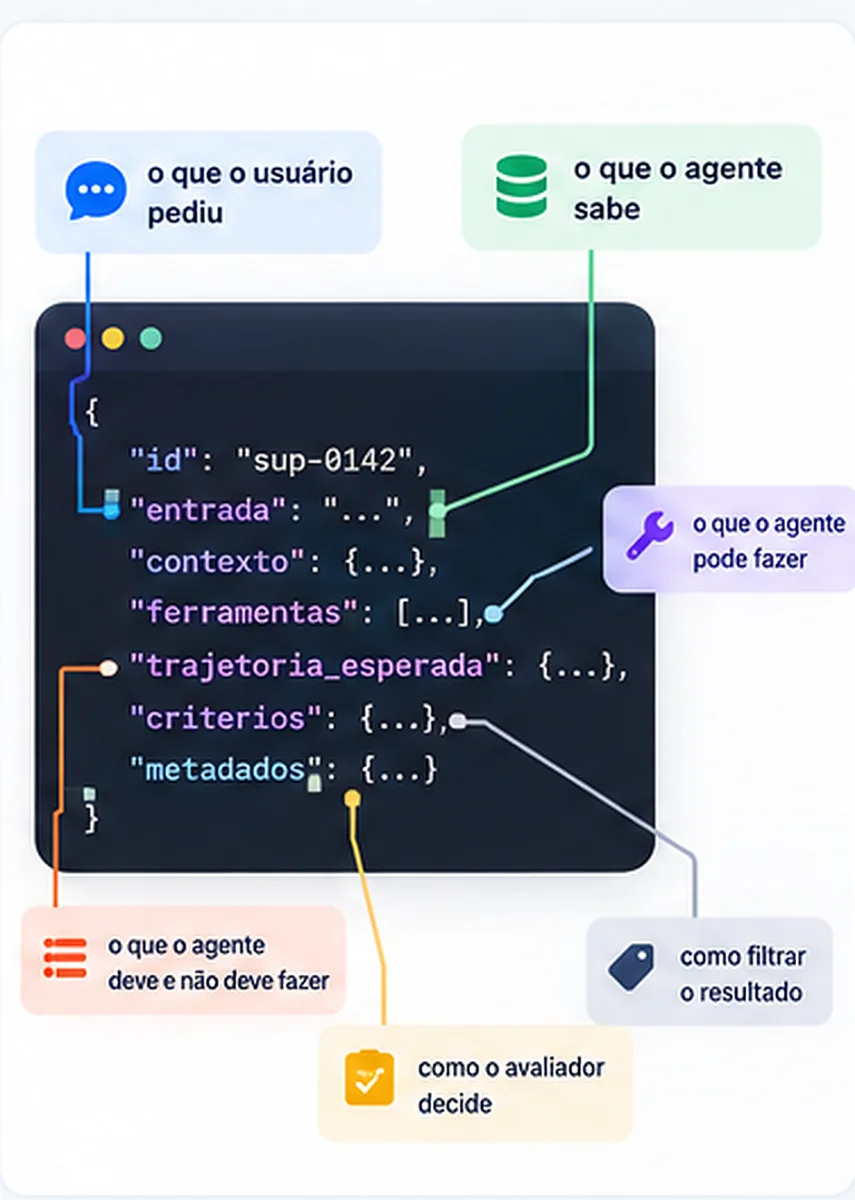
Cada caso do dataset é um registro com campos fixos. Campos fixos permitem rodar a avaliação de forma automática e filtrar o resultado por categoria.
Campo | O que guarda | Exemplo |
|---|---|---|
id | Identificador único que nunca muda | sup-0142 |
entrada | Mensagem do usuário ou a conversa até aquele ponto | "Preciso da segunda via do boleto de outubro" |
contexto | Dados que o agente vê no início | Cliente ativo, duas faturas em aberto |
ferramentas | Ferramentas disponíveis no caso | consultar_fatura, emitir_segunda_via |
trajetória esperada | Chamadas obrigatórias e chamadas proibidas | emitir_segunda_via com fatura_id 8812 |
resposta de referência | Um texto que atende ao critério | "Pronto. Segue o link da segunda via de outubro." |
critérios | Regras que o avaliador responde com sim ou não | Emitiu a fatura 8812? Enviou o link? |
metadados | Categoria, dificuldade, origem e versão | segunda_via, média, produção, v1.2 |
O registro completo do caso sup-0142 fica assim:
{
  "id": "sup-0142",
  "categoria": "segunda_via",
  "dificuldade": "media",
  "origem": "producao_anonimizada",
  "versao_dataset": "1.2",
  "entrada": "Oi, preciso da segunda via do boleto de outubro.",
  "contexto": {
    "cliente_id": "c-0091",
    "status_cliente": "ativo",
    "faturas_em_aberto": [
      {"fatura_id": "8807", "mes": "2026-09", "valor": 1890.00},
      {"fatura_id": "8812", "mes": "2026-10", "valor": 1890.00}
    ]
  },
  "ferramentas_disponiveis": [
    "consultar_fatura", "emitir_segunda_via",
    "abrir_chamado", "transferir_para_humano"
  ],
  "trajetoria_esperada": {
    "obrigatorias": [
      {"ferramenta": "emitir_segunda_via", "parametros": {"fatura_id": "8812"}}
    ],
    "proibidas": ["transferir_para_humano"]
  },
  "resposta_referencia": "Pronto. Segue o link da segunda via do boleto de outubro.",
  "criterios": [
    "Emite a segunda via da fatura 8812",
    "Não emite boleto da fatura 8807",
    "Envia o link na resposta"
  ]
}
O contexto traz duas faturas com o mesmo valor de propósito. O caso testa se o agente escolhe a fatura pelo mês pedido, e não pela primeira da lista.
Duas regras para montar o registro:
A trajetória esperada lista chamadas obrigatórias e proibidas, e não a sequência completa de passos.
Cada critério é uma frase que o avaliador responde com sim ou não. "Resposta clara" não serve; "envia o link na resposta" serve.
De onde vêm os dados
Use quatro fontes, cada uma com um papel. A base vem da produção; as outras três cobrem o que a produção ainda não mostra.
Fonte | Realismo | Custo | Cobre casos raros | Principal risco |
|---|---|---|---|---|
Produção | Alto | Baixo | Pouco | Dado pessoal sem anonimização |
Especialistas | Médio | Alto: horas de especialista | Muito | Viés da memória de quem escreve |
Sintéticos | Baixo a médio | Baixo | Médio | Casos repetitivos e limpos demais |
Adversariais | Baixo | Médio | Muito, em segurança | Lista que envelhece diante de ataques novos |
Logs de produção
Conversas reais trazem a linguagem do cliente: erros de digitação, pedidos ambíguos, duas perguntas na mesma mensagem. Antes do lançamento, use o canal humano atual como fonte: tickets, chats e e-mails do suporte.
Regra: anonimize antes de copiar para o dataset. Troque nome, CPF, CNPJ, e-mail e telefone por valores fictícios no mesmo formato.
Especialistas de domínio
Atendentes experientes e analistas conhecem os casos raros que custam caro. Peça a cada especialista dez casos que ele já viu dar errado, com a resposta certa. Esses casos entram na fatia crítica do dataset.
Dados sintéticos
Um LLM gera variações de um caso real: outra forma de escrever, outro valor, outro mês. Isso amplia a cobertura sem depender de volume de produção.
Casos sintéticos tendem a soar parecidos entre si e mais limpos que a linguagem real. Três regras de uso:
Todo caso sintético parte de um caso real, chamado de semente.
Uma pessoa revisa cada caso antes de ele entrar no dataset.
O campo origem marca o caso como sintético, para o time comparar o desempenho por origem.
Casos adversariais
Inclua tentativas de tirar o agente das regras. Exemplos: o usuário pede a fatura de outro CNPJ, manda o agente ignorar as instruções ou pede um desconto que não existe. Em todos, o comportamento esperado é recusar ou transferir.
Cobertura: quais casos entram
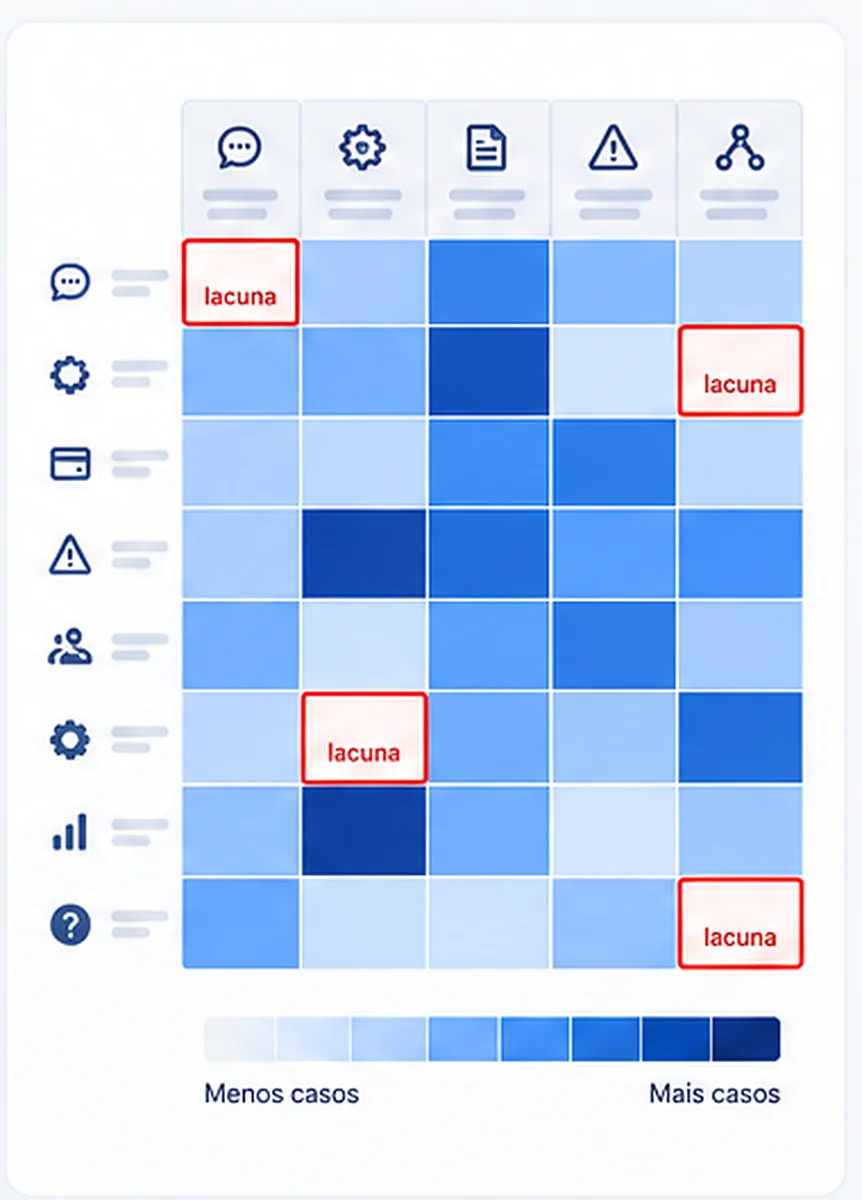
O dataset precisa cobrir as situações que o agente encontra em produção, na proporção certa. A matriz de cobertura mostra onde faltam casos.
Matriz de cobertura
Cruze a intenção do usuário com o tipo de dificuldade. Cada célula precisa de casos suficientes para gerar uma métrica própria.
Intenção | Simples | Ambígua | Com dado faltando | Fora da política |
|---|---|---|---|---|
Segunda via | 12 | 6 | 4 | 3 |
Dúvida de cobrança | 10 | 8 | 3 | 2 |
Cancelamento | 6 | 4 | 0 | 4 |
Falha técnica | 8 | 5 | 5 | 1 |
Fora do escopo | 5 | 3 | 2 | 4 |
No exemplo, cancelamento com dado faltando tem zero casos. É o cenário em que o cliente pede para cancelar sem dizer qual contrato, e ninguém testou o que o agente faz. Falha técnica fora da política tem um caso só, o que não sustenta uma métrica.
Duas fatias: representativa e crítica
Separe o dataset em duas fatias com perguntas diferentes.
Fatia representativa: segue a distribuição real de uso. Se 40% das conversas pedem segunda via, 40% dos casos são de segunda via. Ela responde: qual taxa de sucesso o cliente vai sentir?
Fatia crítica: concentra casos de alto risco, como dado financeiro, cancelamento e tentativa de fraude. Ela responde: o agente comete algum erro que a empresa não aceita?
Reporte as duas fatias em separado. Uma média única esconde a falha rara e cara.
Casos em que o agente não deve agir
Inclua casos em que a ação certa é parar. Três comportamentos precisam de casos próprios:
Pedir informação: o cliente pede um boleto sem dizer o mês, e há três faturas em aberto.
Recusar: o cliente pede dados de outra empresa.
Transferir: o cliente pede algo fora do escopo, como renegociação de dívida.
Sem esses casos, o dataset premia o agente que sempre age, mesmo quando deveria parar.
Rotulagem: quem define a resposta certa
O rótulo é a resposta certa de cada caso. Ele exige um guia escrito, mais de um rotulador e uma medida de concordância entre eles.
Guia de rotulagem
O guia transforma o contrato do agente em regras de decisão. Para cada categoria, ele traz o que define sucesso, o que define falha, três exemplos de cada e os casos de fronteira.
Use escalas de dois ou três níveis, cada nível com uma definição que duas pessoas apliquem do mesmo jeito:
Nota | Definição | Exemplo no caso sup-0142 |
|---|---|---|
2 — Sucesso | Ação certa e resposta completa | Emite a fatura 8812 e envia o link |
1 — Parcial | Ação certa, resposta com falha | Emite a fatura 8812, mas não envia o link |
0 — Falha | Ação errada ou ausente | Emite a fatura 8807, ou diz que emitiu sem chamar a ferramenta |
Concordância entre rotuladores
Peça a duas pessoas que rotulem os mesmos 50 casos sem ver a nota uma da outra. Calcule a concordância com o kappa de Cohen, que desconta o acerto por acaso.
Use como régua inicial: kappa abaixo de 0,6 indica critério ambíguo. Nesse caso, reúna os rotuladores, discuta cada divergência e reescreva o guia antes de rotular o resto.
Quem escreveu o prompt do agente não deve ser o único rotulador. Essa pessoa tende a escrever respostas de referência no formato que o agente já produz, e o dataset passa a medir o próprio prompt.
Trajetória ou resultado
Um agente pode chegar ao mesmo resultado por caminhos diferentes. Se o rótulo exige a sequência exata de ferramentas, o dataset reprova caminhos válidos.
Regra: rotule o resultado final e os passos críticos. Passo crítico é o que muda algo no sistema ou carrega risco: emitir boleto, abrir chamado, transferir. Consultas de leitura podem variar de ordem sem afetar a nota.
Como avaliar o agente com o dataset
A avaliação roda o agente em todos os casos e compara o que ele fez com o rótulo. O resultado sai em três grupos de métricas: resultado, trajetória e operação.
Grupo | Métrica | Definição | Exemplo de meta |
|---|---|---|---|
Resultado | Taxa de sucesso | % de casos com nota 2 | ≥ 85% na fatia representativa |
Resultado | Erros críticos | Casos da fatia crítica com ação proibida | Zero para liberar release |
Resultado | Transferência correta | % dos casos de transferência em que o agente transferiu | ≥ 95% |
Trajetória | Precisão de ferramenta | % das chamadas obrigatórias feitas com os parâmetros certos | ≥ 95% |
Trajetória | Ação declarada e não feita | % de respostas que afirmam uma ação que o agente não executou | 0% |
Trajetória | Passos extras | Média de chamadas além do necessário por caso | ≤ 1 |
Operação | Custo por caso | Gasto com o modelo por caso, em reais | Conforme a margem do produto |
Operação | Latência | Tempo até a resposta final, no percentil 95 | ≤ 10 s |
As metas da tabela são exemplos. Defina as suas pelo custo do erro em cada tarefa.
Três formas de dar nota
Checagem por regra: um script compara chamadas e parâmetros com a trajetória esperada. Use em tudo que tem resposta exata.
LLM como juiz: um modelo lê a resposta e aplica o critério escrito. Use para clareza, tom e completude da explicação.
Revisão humana: uma pessoa avalia uma amostra. Use para calibrar o juiz e para casos novos.
Calibre o juiz antes de confiar nele
Rode o LLM juiz nos mesmos casos que os humanos rotularam e calcule o kappa entre juiz e humanos. Se o valor ficar abaixo da concordância entre os próprios humanos, ajuste o prompt do juiz antes de usar a nota dele em decisão de release.
Compare versões, não números soltos
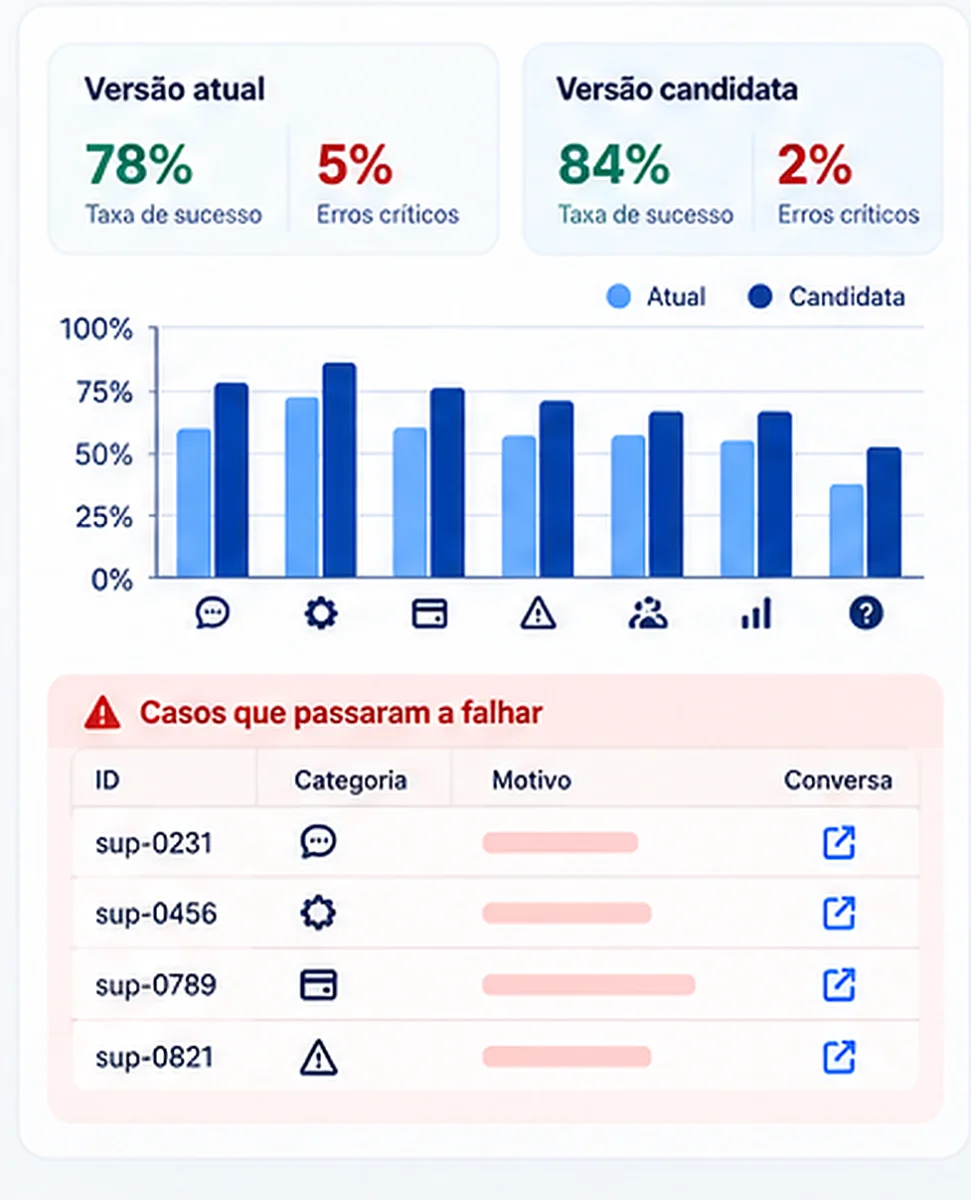
Uma nota isolada diz pouco. Rode a versão atual e a candidata no mesmo dataset e compare por categoria. A candidata só sai se melhorar a métrica-alvo e não piorar nenhuma categoria da fatia crítica.
Tamanho do dataset: quanto basta
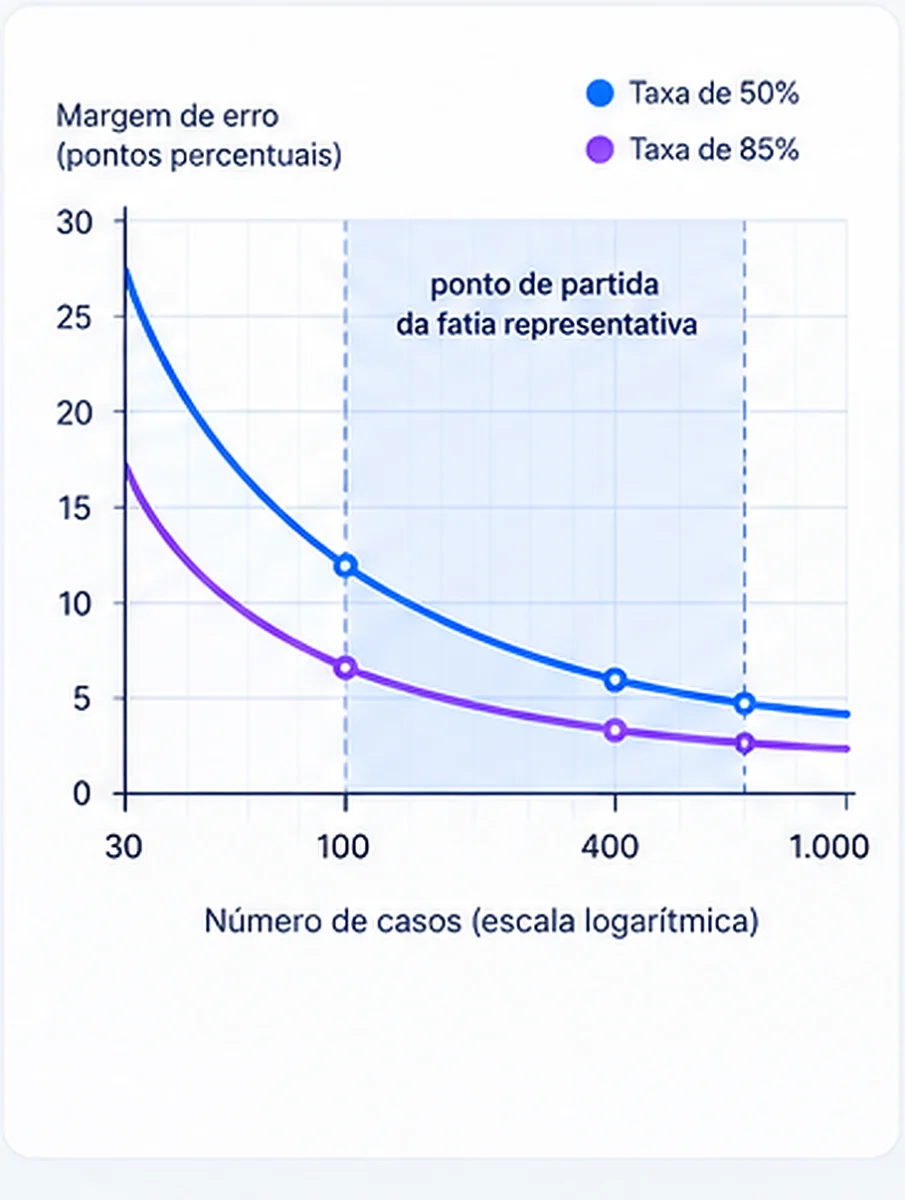
Comece com 50 a 100 casos rotulados com critério e cresça a partir das falhas reais. O tamanho depende da precisão que cada métrica exige.
Toda taxa medida tem margem de erro. Com 95% de confiança, a margem aproximada segue esta conta, em que p é a taxa medida e n é o número de casos:
\text{margem} = 1{,}96 \times \sqrt{\frac{p\,(1-p)}{n}}Casos na categoria | Margem com taxa de 50% | Margem com taxa de 85% |
|---|---|---|
30 | ± 17,9 pp | ± 12,8 pp |
50 | ± 13,9 pp | ± 9,9 pp |
100 | ± 9,8 pp | ± 7,0 pp |
200 | ± 6,9 pp | ± 4,9 pp |
400 | ± 4,9 pp | ± 3,5 pp |
1.000 | ± 3,1 pp | ± 2,2 pp |
Três consequências práticas:
Diferenças pequenas podem ser ruído. Uma melhora de 5 pontos medida em 100 casos fica dentro da margem. Para decidir, compare as versões caso a caso: conte quantos casos a candidata acerta e a atual erra, e o inverso. O teste de McNemar faz essa conta.
A margem vale por categoria. Para medir cancelamento com ± 10 pontos, essa categoria precisa de cerca de 100 casos, e não o dataset inteiro.
A fatia crítica segue outra lógica. Ali a meta é zero erro, e cada caso funciona como teste de regressão. O número de casos acompanha a lista de riscos, e não a estatística.
O ciclo de vida do dataset
O dataset é um ativo com versão, dono e rotina de atualização. Um dataset congelado mede o produto do trimestre passado.
Versionamento
Dê número de versão ao dataset e registre cada mudança: casos novos, casos removidos e rótulos alterados. Toda nota de avaliação cita a versão do dataset que a gerou. Sem isso, o time compara notas de testes diferentes.
Produção alimenta o dataset
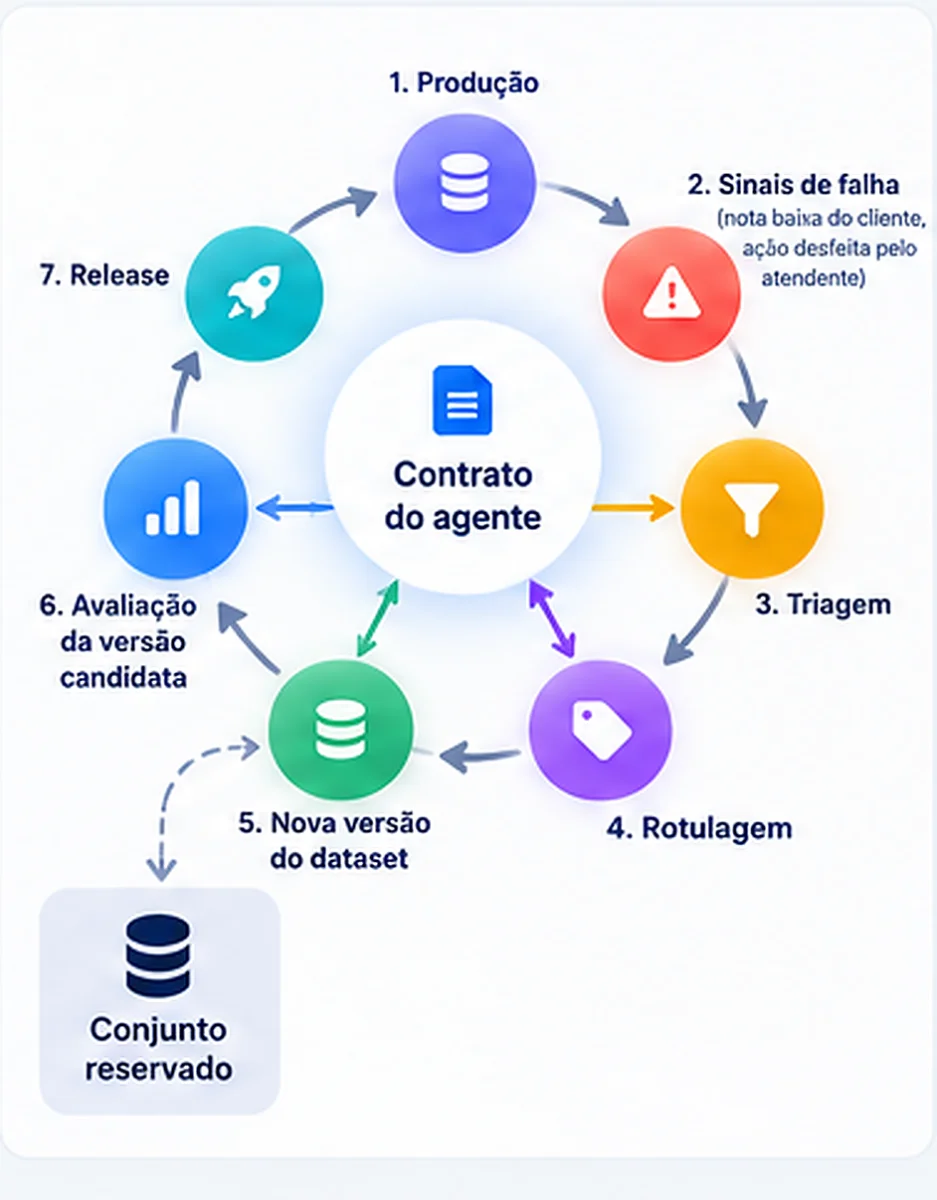
Cada falha em produção vira candidata a caso. O fluxo: o cliente avalia mal a conversa ou um atendente desfaz a ação do agente; alguém faz a triagem; o caso aprovado ganha rótulo e entra na próxima versão.
Defina uma meta de fluxo. Exemplo: toda semana, o time faz a triagem de 20 conversas com nota baixa.
Contaminação e conjunto reservado
Quando o time ajusta o prompt olhando os mesmos casos várias vezes, o agente melhora no dataset e não no uso real. Separe 20% dos casos como conjunto reservado. Ninguém consulta esses casos durante o ajuste; eles só rodam antes da release.
Sinal de alerta: a nota no conjunto de trabalho sobe e a nota no reservado fica parada. Nesse caso, o time ajusta o agente para a prova, e não para o cliente.
Revisão a cada mudança de regra
Regras de negócio mudam: preço, política de cancelamento, ferramentas novas. Cada mudança no contrato do agente dispara a revisão dos casos afetados. Casos com regra antiga saem do dataset ou ganham rótulo novo.
Governança, privacidade e LGPD
O dataset que nasce da produção contém dados de clientes. Aplique a ele as mesmas regras de acesso e retenção do banco de dados de produção.
Anonimização antes da entrada: troque nome, CPF, CNPJ, e-mail, telefone e endereço por valores fictícios no mesmo formato. O formato mantido evita que o agente reaja a um dado com cara de falso.
Acesso restrito: só quem rotula e avalia acessa o dataset. Registre quem acessou e quando.
Base legal e retenção: defina com o jurídico e o encarregado de dados (DPO) a base legal do uso e o prazo de guarda dos casos.
Fornecedores externos: não envie casos com dado pessoal para ferramentas de geração sintética ou de rotulagem sem contrato que cubra esse uso.
Registro de origem: todo caso informa de onde veio — produção, especialista, sintético ou adversarial — e a data de entrada.
Estas práticas são operacionais. A interpretação da LGPD para o seu caso cabe ao time jurídico.
Papéis e responsabilidades
O dataset precisa de um dono. Em produto, o dono é o PM do agente, porque o dataset decide o que o produto entrega.
Papel | Decide | Executa |
|---|---|---|
Product manager | Contrato do agente, metas de release, prioridade das lacunas da matriz | Matriz de cobertura, triagem semanal com o suporte |
Especialista de domínio | Resposta certa nos casos de fronteira | Casos críticos e respostas de referência |
Engenharia ou ML | Formato do registro e ferramenta de avaliação | Execução da avaliação, juiz automático, versionamento |
QA | Critério de regressão | Casos adversariais e testes de regressão |
Jurídico e privacidade | Regras de anonimização e retenção | Revisão de contratos com fornecedores |
Operação de suporte | Quais falhas viram candidatas a caso | Envio dos sinais de falha da produção |
Erros comuns
Cada erro abaixo tem um sintoma que o PM consegue observar e uma correção.
Erro | Sintoma | Correção |
|---|---|---|
Só casos fáceis | A nota sobe e as reclamações continuam | Matriz de cobertura e fatia crítica |
Rótulo escrito por quem fez o prompt | As respostas de referência copiam o estilo do agente | Especialista rotula; duas pessoas rotulam a mesma amostra |
Sintético sem revisão | O agente vai bem no teste e falha na linguagem real | Semente real, revisão humana e campo de origem |
Média única | Taxa geral de 88% com 40% de falha em cancelamento | Reportar por categoria e por fatia |
Avaliar só o texto final | O agente diz que abriu o chamado e não abriu | Avaliar trajetória e efeito no sistema |
Dataset congelado | A nota fica estável enquanto as regras do negócio mudam | Versionamento e triagem semanal das falhas |
Juiz automático sem calibração | A nota do juiz diverge do que os especialistas dizem | Comparar juiz e humanos antes de usar a nota |
Plano de 30 dias para começar
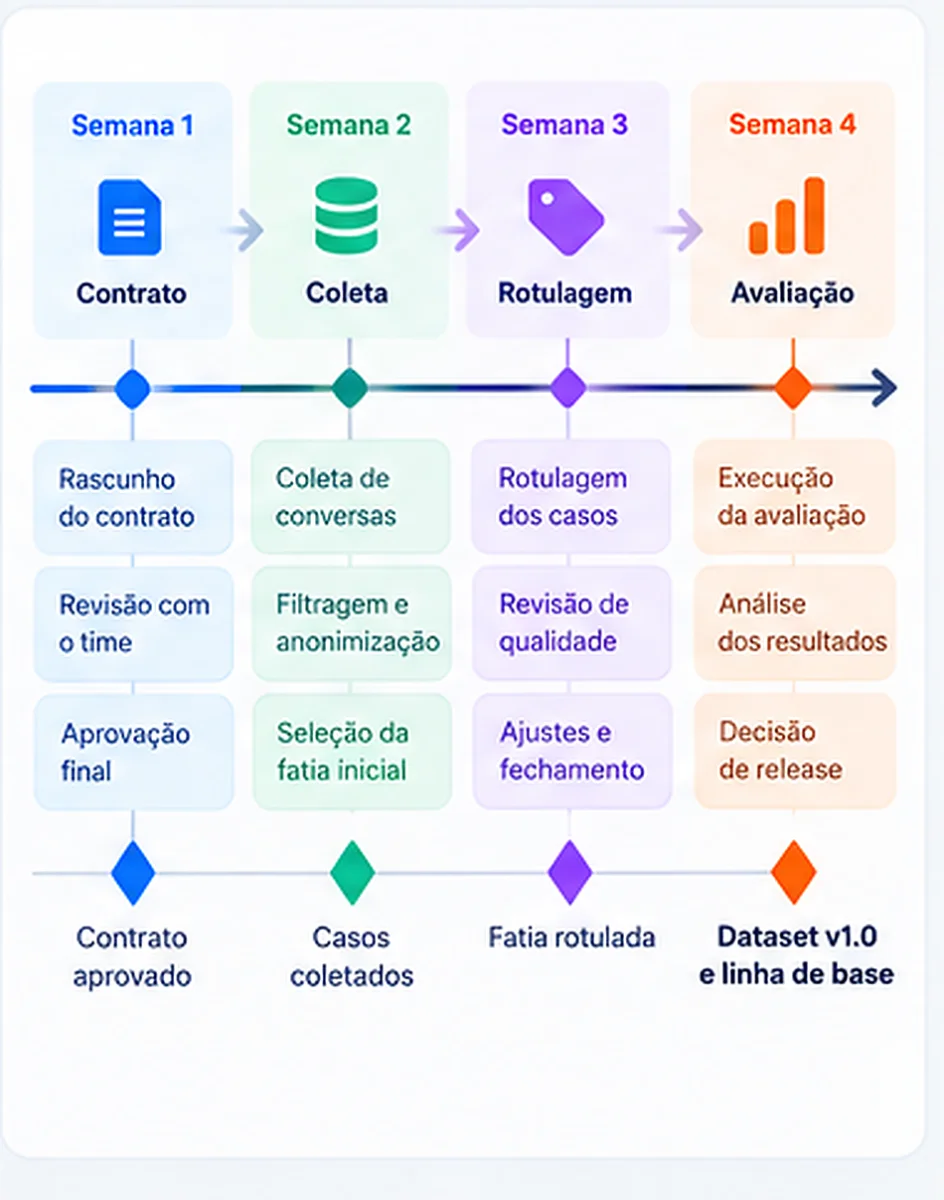
Em quatro semanas, o time sai do zero para um dataset v1.0 com linha de base medida e critério de release escrito.
Semana 1 — Contrato e taxonomia
Escreva o contrato do agente em uma página.
Liste as intenções e monte a matriz de cobertura vazia.
Pronto quando: especialista e engenharia aprovam o contrato.
Semana 2 — Coleta
Separe 150 conversas reais do canal atual e anonimize.
Peça dez casos críticos a cada especialista.
Escreva a primeira versão do guia de rotulagem.
Pronto quando: 100 casos preenchem as células principais da matriz.
Semana 3 — Rotulagem e concordância
Duas pessoas rotulam os mesmos 50 casos.
Calcule o kappa e reescreva o guia nos pontos de divergência.
Rotule o restante e separe 20% como conjunto reservado.
Pronto quando: kappa igual ou acima de 0,6 e dataset v1.0 publicado.
Semana 4 — Primeira avaliação
Rode o agente atual no dataset e registre a linha de base por categoria.
Calibre o LLM juiz contra os rótulos humanos.
Defina com o time as metas de release e a regra de erro crítico zero.
Pronto quando: a próxima release tem critério de liberação escrito.
Conclusão: o que o dataset muda na estratégia de produto
O dataset é a peça de produto que define como o agente se comporta. Cinco pontos para PMs e heads de produto levarem para o planejamento:
O dataset é a especificação. Cada caso com critério escrito é um requisito testado a cada versão. O PM que escreve os casos define o comportamento do agente com mais precisão do que um PRD em texto corrido.
O modelo muda, o dataset fica. Os fornecedores lançam modelos novos várias vezes por ano. Com um dataset próprio, o time testa um modelo novo em horas e decide a troca com números por categoria, e não com uma demonstração.
O dataset é a parte que o concorrente não copia. Qualquer empresa contrata os mesmos modelos. Os casos rotulados do seu domínio, com as regras do seu negócio e as falhas que seus clientes já viveram, só existem dentro da sua empresa.
Critério de release substitui debate. Com metas por categoria e a regra de erro crítico zero, a decisão de lançar deixa de depender de quem fala mais alto na reunião.
O head de produto trata o dataset como ativo de portfólio. Ele precisa de dono, de capacity no planejamento, de roadmap próprio e de métricas de saúde: casos por categoria, idade média dos casos, concordância entre rotuladores e casos novos vindos da produção por semana.
O primeiro passo cabe em uma semana: escrever o contrato do agente e rotular os primeiros 50 casos com duas pessoas. Cem casos com critério escrito e rótulo conferido orientam mais decisões do que dez mil casos sem critério.